Architecture data mesh : principes clés, outils et limites pour l'ingénierie collaborative
Admin Janus
admin
Pendant deux décennies, la stratégie data des grandes entreprises a suivi une logique unique : tout centraliser. Un entrepôt de données monolithique d'abord, puis un data lake pour absorber les données brutes, et une équipe centrale chargée d'orchestrer le tout. Le résultat ? Des goulots d'étranglement chroniques, des projets qui s'éternisent, et des équipes métier frustrées de ne pas pouvoir exploiter leurs propres données.
Le data mesh propose de retourner ce modèle. Théorisé par Zhamak Dehghani, le concept de data mesh applique au monde de la donnée ce que les microservices ont fait au logiciel : une architecture distribuée où chaque domaine devient propriétaire et responsable de ses propres data products. Cette nouvelle approche séduit, et pour de bonnes raisons.
Mais derrière l'enthousiasme se cache une question rarement posée : le data mesh suffit-il vraiment lorsque l'enjeu n'est plus seulement analytique, mais collaboratif ? En ingénierie système, en MBSE, ou plus largement dans les contextes où plusieurs équipes doivent raisonner ensemble sur des modèles hétérogènes, cette architecture distribuée révèle des limites structurelles que les outils actuels ne savent pas encore combler. Cet article explore les principes de data mesh, ses outils, et ses limites, particulièrement dans une perspective d'ingénierie collaborative où la sémantique compte autant que la disponibilité de la donnée.
Du data warehouse au data mesh : un changement d'architecture
L'architecture de données traditionnelle reposait sur deux piliers : le data warehouse pour les données structurées, et plus tard le data lake pour absorber tout le reste. Dans les deux cas, le principe restait identique : centraliser les données dans un référentiel unique géré par une équipe d'experts spécialisés.
Cette approche a montré ses limites. Plus l'entreprise grandit, plus les sources de données se multiplient, plus l'équipe centrale devient un goulot d'étranglement. Les ingénieurs data passent leur temps à construire des pipelines de données pour des domaines qu'ils ne maîtrisent pas, les data scientists attendent des semaines avant d'obtenir des données fiables, et les utilisateurs métier finissent par recréer leurs propres silos en parallèle.
L'approche data mesh prend le contre-pied de cette logique. Plutôt que de centraliser, elle propose de décentraliser. Plutôt que de confier la donnée à une équipe technique, elle la rend aux experts métier. Le parallèle avec les microservices est frappant : comme on a appris à découper les applications monolithiques en services indépendants, on apprend désormais à découper le data management en domaines autonomes.
Data mesh vs data fabric : éviter la confusion
Ces deux concepts sont souvent confondus. La data fabric est une couche technologique d'intégration et d'automatisation qui s'appuie sur les métadonnées et l'IA pour unifier l'accès aux données. Le data mesh, lui, est avant tout un modèle organisationnel et architectural. L'un n'exclut pas l'autre, et beaucoup d'entreprises combinent les deux, mais leurs philosophies diffèrent : la première cherche à résoudre l'hétérogénéité par la technologie, le second par la responsabilisation des équipes. La comparaison data mesh vs data fabric est moins une opposition qu'une distinction de niveau : l'un parle d'organisation, l'autre d'outillage.
Les quatre piliers du data mesh
Les principes de data mesh tels que définis par Zhamak Dehghani s'organisent autour de quatre piliers interdépendants qui forment ensemble un écosystème cohérent.
Propriété par domaine (Domain Ownership)
Le premier principe redonne la responsabilité de la donnée à ceux qui la produisent. Le marketing gère ses données marketing, la logistique ses données logistiques, la finance ses données financières. Chaque domaine devient propriétaire de ses propres produits de données, ce que l'on appelle le data ownership. La propriété des données devient ainsi distribuée entre différents domaines, alignée sur la connaissance métier réelle.
L'avantage est immédiat : les équipes qui connaissent le mieux la donnée sont celles qui la gèrent. Plus besoin de traduire en permanence le contexte métier à une équipe centrale. La connaissance reste là où elle a été produite.
La donnée comme un produit (Data as a Product)
Deuxième principe : traiter chaque jeu de données comme un produit, avec ses utilisateurs, sa documentation, ses SLA, et ses normes de qualité des données. L'idée est puissante : une donnée n'a de valeur que si elle est consommée. Et pour être consommée, elle doit être facile à trouver, lisible, fiable et bien documentée. C'est l'application au data management des disciplines du génie logiciel : versioning, monitoring, retours utilisateurs.
Cette discipline rapproche les ingénieurs data des pratiques produit. Un data product n'est plus un fichier brut déposé dans un data lake, mais une ressource maintenue, documentée, et orientée vers ses consommateurs de données. La fiabilité devient un engagement contractuel, pas une promesse implicite.
Plateforme de données en libre-service (Self-serve Data Platform)
Pour éviter que chaque domaine ne réinvente sa propre infrastructure, une équipe transverse fournit une plateforme de données mutualisée. Cloud, outils de data engineering, monitoring, sécurité : tout est packagé pour permettre à un domaine de produire et publier ses données en libre-service, sans devenir expert en infrastructure.
Cette mutualisation est ce qui rend l'autonomie viable. Sans elle, la décentralisation se traduit par une explosion de la dette technique; chacun reconstruisant ses propres pipelines, son propre stockage, ses propres outils de qualité.
Gouvernance fédérée (Federated Computational Governance)
Décentraliser ne signifie pas abandonner toute coordination. Le quatrième pilier impose des standards globaux : règles de sécurité, formats d'identifiants, métadonnées obligatoires, politiques de conformité. Cette data governance fédérée s'applique automatiquement, sans repasser par une revue manuelle à chaque publication. La gouvernance des données reste une responsabilité partagée, mais outillée et automatisée.
L'équilibre recherché est subtil : autonomie locale pour la créativité, règles globales pour l'interopérabilité. C'est précisément ce point d'équilibre qui distingue un déploiement réussi d'un simple éclatement chaotique des silos.
Les outils du data mesh
Une architecture data mesh ne se déploie pas avec un outil unique. Elle s'appuie sur un écosystème dont la composition dépend du niveau de maturité data de l'organisation et de la nature de ses domaines de données.
Le catalogue de données est central. Sans catalogue de données, impossible pour un consommateur de découvrir les data products disponibles, leur propriétaire, leur qualité ou leur fraîcheur. Des outils comme DataHub, Collibra, Atlan ou Alation se sont imposés comme des références. Leur rôle dépasse la simple documentation : ils deviennent le point d'entrée unique pour explorer les domaines de données de l'entreprise.
Les plateformes cloud (AWS, Azure, GCP, Snowflake, Databricks) fournissent l'infrastructure mutualisée. Elles permettent à un domaine de provisionner ses propres ressources de stockage et de calcul sans dépendance directe à une équipe ops centralisée. Le cloud n'est pas une exigence stricte du data mesh, mais c'est lui qui rend le self-service économiquement viable à grande échelle.
Les outils de data engineering orchestrent la production des produits de données : dbt pour la transformation, Airflow ou Dagster pour l'orchestration, Kafka pour le streaming, Great Expectations pour la qualité des données. La promesse est qu'une équipe peut composer sa propre stack tout en respectant les standards globaux fixés par la gouvernance fédérée.
L'intégration avec l'IA et la data science est un autre vecteur de valeur. Un data product bien conçu devient un input direct pour les modèles de machine learning, ce qui réduit drastiquement le travail de préparation des données, souvent estimé à 80% du temps de modélisation. Le data mesh encourage ainsi un cercle vertueux : plus les données de haute qualité sont disponibles, plus l'IA produit de valeur, plus les domaines sont incités à investir dans leurs produits.
Quand adopter le data mesh ? Une question de maturité
Le data mesh n'est pas une réponse universelle. Avant de se lancer, il faut évaluer la maturité de l'organisation sur plusieurs dimensions : maturité organisationnelle (les équipes métier sont-elles prêtes à assumer la gestion des données qu'elles produisent ?), maturité technique (la plateforme self-service existe-t-elle, ou faut-il la construire ?), et maturité culturelle (l'entreprise sait-elle penser un produit de données comme une ressource versionnée et maintenue, avec ses utilisateurs et ses SLA ?).
Pour une organisation avec quelques sources de données et une équipe data centrale qui tient le choc, une approche centralisée bien outillée reste souvent plus efficace. Le data mesh devient pertinent à partir d'un seuil critique : multiplication des domaines, diversité forte des cas d'usage, ralentissement perceptible de l'équipe centrale. C'est typiquement au-delà de quelques dizaines de sources hétérogènes que le coût de la centralisation dépasse celui de la décentralisation.
Le risque inverse, à l'autre bout du spectre, est l'adoption précipitée. Beaucoup d'entreprises se sont lancées dans cette démarche sans avoir préalablement structuré leur gouvernance des données ni outillé leurs équipes. Résultat : une décentralisation qui amplifie les silos au lieu de les supprimer. Les produits de données prolifèrent sans cohérence, le catalogue de données se transforme en cimetière de datasets oubliés, et la promesse d'autonomie tourne au chacun-pour-soi. Sans discipline produit et sans plateforme robuste, l'approche ne tient pas ses promesses, elle les caricature.
Les limites du data mesh dans l'ingénierie collaborative
C'est ici que la critique commence. Le data mesh, dans sa forme actuelle, a été pensé pour des cas d'usage analytiques : reporting, BI, machine learning sur de la donnée d'entreprise relativement homogène. Lorsqu'on sort de ce périmètre, particulièrement dans des contextes d'ingénierie collaborative, les limites apparaissent, et elles sont structurelles, non conjoncturelles.
La pauvreté sémantique des contrats de données
Le data mesh repose largement sur des data contracts définis en YAML ou JSON Schema. Ces contrats décrivent une structure : voici les champs, voici leurs types, voici les contraintes. Mais ils ne décrivent pas le sens. Un champ client_id peut signifier une chose pour la logistique (une adresse de livraison) et tout autre chose pour la finance (un compte de facturation). Le contrat valide la forme, pas la signification.
Cette pauvreté sémantique n'est pas accidentelle. Elle reflète un choix de pragmatisme face à la complexité du Web sémantique (RDF, OWL, SPARQL) qui n'a jamais vraiment réussi à percer en entreprise. OSLC (Open Services for Lifecycle Collaboration) avait tenté un compromis avec ses Resource Shapes, mais en se rapprochant d'un simple JSON Schema RDF-isé, il a perdu la puissance d'inférence qui faisait la richesse d'OWL2. Le data mesh hérite de ce compromis appauvri : on supprime les silos sans préserver une sémantique globale.
Le syndrome du Bounded Context
L'approche data mesh emprunte au Domain-Driven Design la notion de Bounded Context : chaque domaine définit librement ses concepts à l'intérieur de ses frontières. C'est efficace pour préserver l'autonomie, mais cela rend le raisonnement transversal extrêmement difficile.
Concrètement : si le marketing appelle un client ID_CUST et la vente CLIENT_REF, sans une couche de liaison sémantique, croiser les deux relève de l'archéologie. La gouvernance fédérée du data mesh impose des identifiants pivots, mais elle ne résout pas la polysémie des concepts métier. Le bounded context est une force pour produire, c'est une faiblesse pour raisonner.
Le biais analytique
Le data mesh a été pensé par et pour les analystes et les profils data orientés BI. Ses outils, ses patterns, son vocabulaire sont marqués par cet héritage. Lorsqu'on cherche à l'appliquer à de l'ingénierie collaborative (ingénierie système, MBSE, conception mécanique, simulation), le décalage devient flagrant.
Un ingénieur système ne consomme pas des données pour faire du reporting. Il a besoin de raisonner sur des modèles hétérogènes : exigences, simulations thermiques, modèles CAO, analyses de fiabilité. La question n'est pas tant « où sont les données ? » que « ces deux modèles sont-ils cohérents entre eux ? ». Le data mesh sait répondre à la première question. Il ne sait pas répondre à la seconde.
L'absence de boucle de rétroaction
Dans un data mesh classique, le flux est unidirectionnel : un domaine produit, un consommateur consomme. Si le consommateur détecte une incohérence, il doit ouvrir un ticket, attendre, espérer que le domaine source corrige.
Pour de l'ingénierie collaborative, ce modèle est insuffisant. Lorsqu'une règle de cohérence est violée, par exemple une exigence thermique incompatible avec un choix de matériau, le feedback doit revenir directement dans l'outil métier de l'ingénieur concerné, en temps réel, sans passer par une couche analytique externe. C'est ce que la communauté MBSE appelle un Digital Thread bidirectionnel, et que le data mesh actuel ne sait pas instrumenter. Sans cette boucle, le « fil numérique » devient, pour reprendre une image juste, une corde pour se pendre dans la complexité.
Échange syntaxique versus interopérabilité sémantique
C'est peut-être la limite la plus profonde. Le data mesh, comme OSLC avant lui avec ses Resource Shapes, a privilégié l'échange syntaxique (partager des fichiers conformes à un schéma) au détriment de l'interopérabilité sémantique (partager du sens). Tant que cette distinction reste floue, on supprime les silos sans permettre le raisonnement global. Les domaines de données coexistent, mais ils ne dialoguent pas vraiment.
Vers un Semantic Mesh : combiner data mesh et raisonnement sémantique
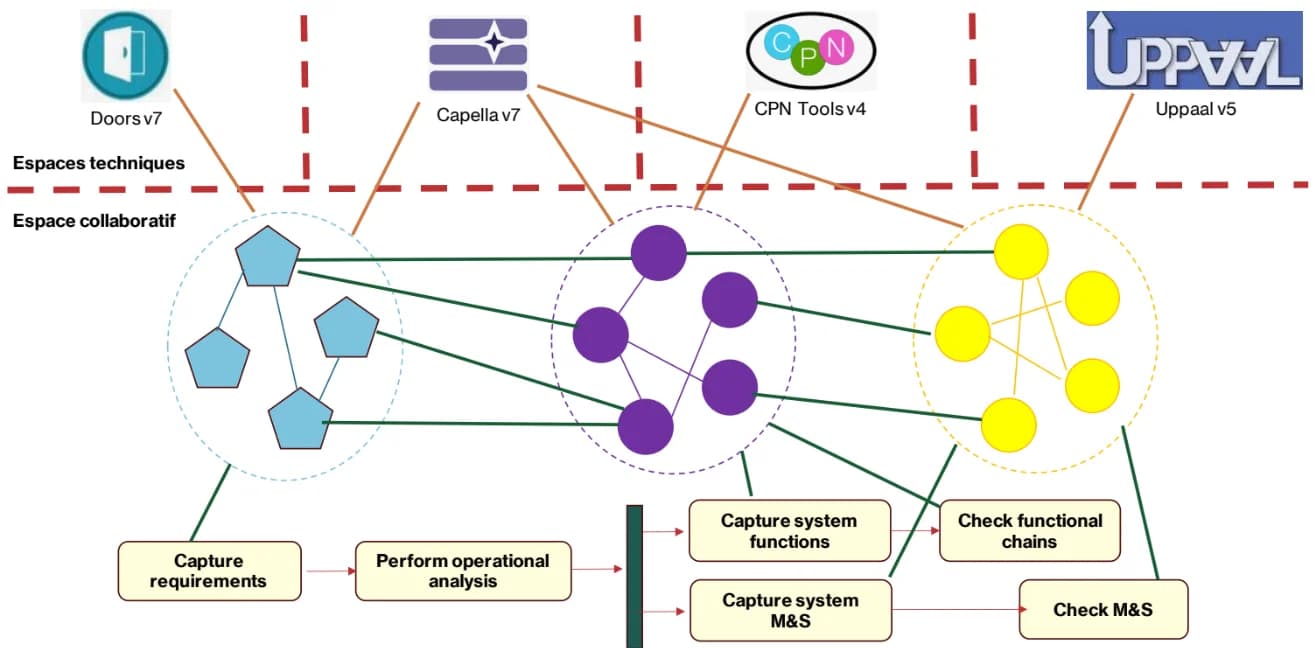
La voie d'évolution la plus prometteuse consiste à superposer une couche de raisonnement sémantique au-dessus du data mesh existant. Plutôt que d'imposer une ontologie globale, chimère qui a coulé le Web sémantique en entreprise , l'idée est de créer des espaces collaboratifs dédiés à la résolution de problèmes précis : gouvernance, optimisation, dimensionnement.
Dans ces espaces, les données hétérogènes provenant de différents domaines sont enrichies par des ontologies légères (OWL2) et des règles d'inférence (SWRL). Un raisonneur peut alors détecter automatiquement les incohérences, déduire de nouvelles relations, et déclencher un feedback direct dans les outils sources. On passe de la gouvernance déclarative à la gouvernance computationnelle : les règles ne sont plus écrites dans un document Word, elles s'exécutent.
Cette approche, nommée Semantic Mesh, hérite de plusieurs traditions : le partage intentionnel plutôt que l'exposition passive, la sémantique fédérée plutôt que l'ontologie universelle, et le just-in-time modeling : on ne modélise pas tout, on modélise au moment où la collaboration l'exige. Le résultat n'est pas un nouveau silo, mais un bac à sable sémantique mobilisé pour un problème, puis dissous une fois le problème résolu.
L'IA générative joue ici un rôle d'accélérateur intéressant : les LLM peuvent traduire le langage naturel en règles SWRL ou en fragments d'ontologie, abaissant la barrière à l'entrée historique du Web sémantique. Ce qui était réservé aux ontologistes devient progressivement accessible à un ingénieur métier, sans qu'il ait besoin de devenir lui-même expert en logique de description.
Conclusion
Le data mesh est une avancée majeure. Il a permis à des organisations entières de sortir du goulot d'étranglement des architectures centralisées et de remettre la responsabilité de la donnée entre les mains des experts métier. Les piliers posés par Zhamak Dehghani (domain ownership, data as a product, plateforme self-service, gouvernance fédérée) restent une référence solide pour toute organisation data-driven.
Mais il faut le voir pour ce qu'il est : une étape, pas une destination. Pour les contextes purement analytiques, le data mesh suffit largement. Pour l'ingénierie collaborative, le MBSE, ou tout cas d'usage où plusieurs domaines doivent raisonner ensemble sur des modèles hétérogènes, il manque une couche : celle du sens. Combiner data mesh et sémantique formelle (Semantic Mesh, espaces collaboratifs avec inférence, feedback bidirectionnel) n'est pas un luxe académique. C'est la condition pour que la décentralisation tienne ses promesses sans se transformer, à terme, en marécage de données distribué.
Formations Associées
- MBSE avec Arcadia et Capella : Architecture Système
- SysML : Modélisation Standardisée des Systèmes
- Matlab & Simulink pour l'Ingénierie Système
- Ingénierie des Modèles : Créer ses propres outils
- Analyse de la Valeur : Optimiser la Conception Système dans le MBSE
- Ingénierie des Exigences : Capter et Spécifier le Besoin Système
Envie d'approfondir ?
Découvrez nos formations pour développer vos compétences.